Сначала видеопамять, не имя чипа
При локальном запуске узкое место — не игровая «мощность», а то, помещаются ли веса в видеопамять. Если модель целиком сидит в VRAM, расчёт идёт по шине карты. Если не сидит, система гоняет тензоры через оперативку и диск, и процессор это уже не вытягивает.
Видеокарту для нейросетей выбирают в таком порядке: объём видеопамяти, затем пропускная способность памяти, затем процессор. Игры смотрят на кадры, здесь смотрят, влезет ли модель без выгрузки слоёв. Конкретные токены в секунду на чужой машине мы не обещаем — зависит от экземпляра и самой модели.
Для Stable Diffusion запас VRAM нужен ещё и потому, что вместе с чекпоинтом живут VAE, ControlNet и батч. Для LLM тот же запас решает, какую модель можно держать локально без агрессивного квантования. Имя чипа вторично: сначала смотрим, сколько памяти на плате.
Почему старшая карта закрывает младшие
Старшая карта закрывает то, что младшие уже не держат целиком: более крупную LLM, более длинный контекст, в Stable Diffusion — выше разрешение и несколько сетей сразу. Упираются младшие карты не в шейдеры, а в объём. Когда веса не влезают, широкая шина не помогает — модель физически не хранится на плате.
Квантование и нарезка слоёв позволяют запустить крупное на меньшем объёме, но это уже компромисс по качеству и скорости. Если задача — держать модель резидентно и не ждать выгрузки на процессор, берётся карта старшего класса. RTX 5090 даёт тот запас, ради которого собирают рабочую машину, а не игровую с тем же именем чипа.
В витрине сборки на RTX 5090 — 949 000 ₽, 999 990 ₽ и 1 499 990 ₽. Младшие полки на 5080 и 5070 Ti закрывают черновики и небольшие модели. Какая карта нужна, считаем по проекту: от того, что должно влезать целиком.
Шина и процессор идут следом
Когда модель уже в видеопамяти, работает пропускная способность. Чем шире и быстрее память карты, тем быстрее гоняются активации внутри слоёв. Старший чип выигрывает не магией нейросетей, а тем, что шина шире. Карта с тем же формальным объёмом, но узкой памятью будет просто дольше считать тот же промпт.
Процессор здесь не главный. Он токенизирует, держит очередь, обслуживает диск и фреймворк. Для инференса на видеокарте хватает современного многоядерного чипа без погони за игровым кэшем. Имеет смысл не экономить на питании и охлаждении: долгий прогон греет карту иначе, чем игровой бенчмарк, и стабильность важнее пикового балла.
Я сначала спрашиваю, какая модель должна влезать целиком. От этого выбирается карта, не от индекса в названии.
Оперативка и диск под веса
Видеопамять держит активную модель. Оперативная память нужна, чтобы поднять веса, квантование, несколько чекпоинтов в очереди и сам фреймворк. Если оперативки мало, система свопит на диск в момент загрузки — и кажется, что тормозит карта, хотя узкое место уже в RAM.
Диск под веса — быстрый NVMe с запасом места. Моделей обычно несколько, плюс датасеты и кэш. Скорость накопителя влияет на время старта и смены модели, не на токены после того, как всё легло в VRAM. Экономить на объёме диска в такой машине бессмысленно: веса копятся быстрее, чем кажется на старте.
Точный объём оперативки и накопителя считаем по проекту. Зависит от того, какие модели живут локально и сколько их держать одновременно. Универсальную цифру на все LLM назвать нельзя.
Собрать ПК для нейросетей в мастерской
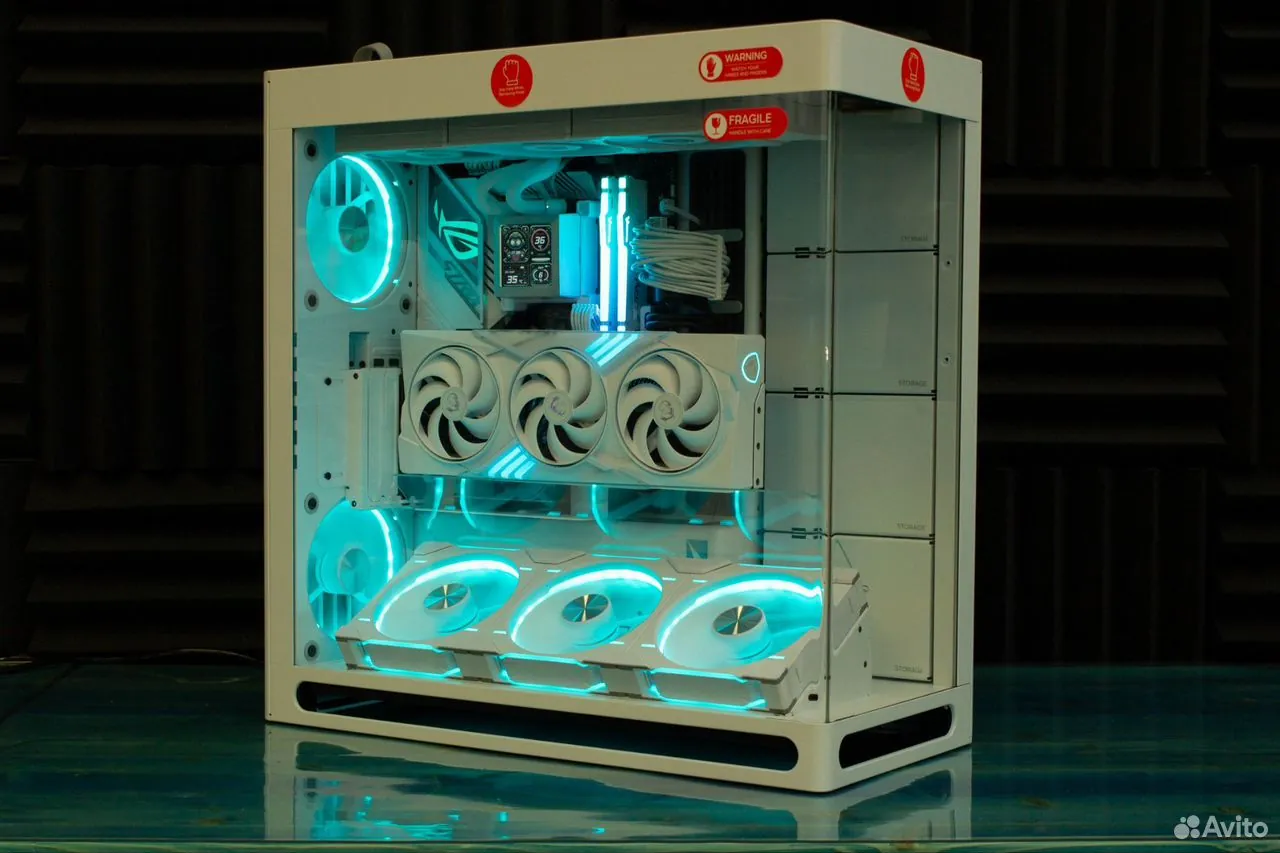
Такие машины собираем и продаём мы: комплектующие, сборка, кабель-менеджмент, настройка BIOS, установка софта, тесты. Сборка бесплатна при покупке комплектующих у нас, из своих деталей — от 9 990 ₽. Перед выдачей каждая сборка проходит 48 часов стресс-тестов на стенде в закрытом корпусе. Гарантия на сборку — до 3 лет, точный срок называется при покупке. Готовые ПК в витрине — от примерно 180 000 ₽ до примерно 1 000 000 ₽, под заказ — от 60 000 ₽ до 1,5 млн ₽. Наличие смотрим по складу и витрине, самовывоз в Москве на Варшавском шоссе, 95, корп. 1, запись по телефону +7 (925) 377-28-79 или в Telegram.
итог мастерской
Локальные нейросети упираются в видеопамять: сначала VRAM, потом шина, процессор третьим. Старшая карта закрывает модели, которые младшие уже не держат целиком.
Замеры сделаны на стенде мастерской в Москве, если не указано иное. Обновлено 21 сентября 2026.